HTTP是一个无状态的协议,但Web服务又需要认出访客(比如登录等功能),这两者就产生了一个矛盾。为了解决这个矛盾,前人想出了一些认证的办法,来证明“我是我,你是你”。
HTTP Basic Auth
HTTP状态码中有一个401 unauthorized状态码,服务端用来告诉客户端“未验证”,并在WWW-Authenticate头告诉客户端应该进行何种验证。Basic Auth算是验证方式最简单的一种。
我们用Flask构建一个要求basic验证的服务。
from flask import Flask, render_template
from flask_basicauth import BasicAuth

app = Flask(__name__)

app.config['BASIC_AUTH_USERNAME'] = 'example'
app.config['BASIC_AUTH_PASSWORD'] = 'foo'

basic_auth = BasicAuth(app)

@app.route('/secret')
@basic_auth.required
def secret_view():
    return render_template('secret.html')

if __name__ == "__main__":
    app.run()
当我们访问/secret这个路由时,浏览器会跳出输入框让我们输入用户名和密码(严格来说是口令),当我们输入完example和foo后,secret.html就渲染出来了。
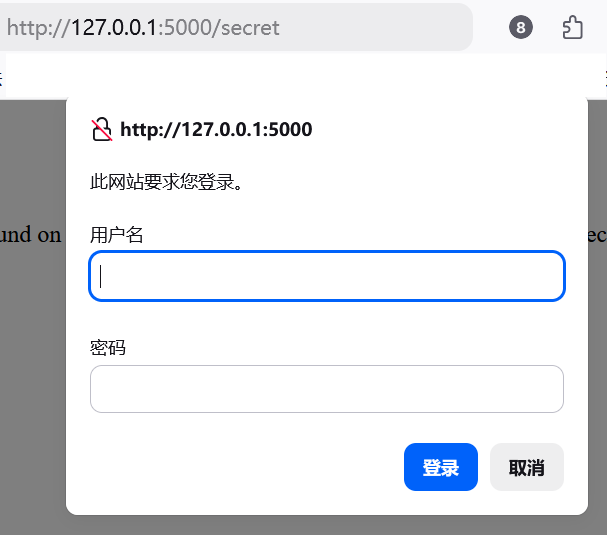
可以看到刚才的鉴权页面服务器给浏览器发送了一个401状态码,和WWW-Authenticate: Basic realm=""头,这跟我们刚才的描述一样。它告诉浏览器要用Basic Auth进行身份验证。这里的realm有什么用呢?它描述受保护区域的字符串。realm允许服务器对它受保护的区域进行区分(如果允许支持这种划分方案),并通知用户需要哪个特定的用户名/密码。如果未指定 realm,客户端通常会显示格式化的主机名。1Emm,感觉不太会用到。但这个字段又是必须的(参见 RFC7235 第2.2节,但 MDN 又标明这个字段是可选的)。
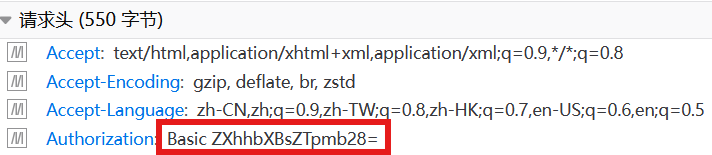
我们可以看到浏览器在请求这个页面的时候在Authorization里面加了一个Basic ZXhhbXBsZTpmb28=,Basic代表使用的鉴权方式是Basic Auth,后面那个字符串是一个base64编码。解码之后得到example:foo,也就是username:passwd。
浏览器有时会重用之前的验证信息,这样就不用每次都验证了。比如在http://example.com/docs/index.html经过的身份验证,访问http://example.com/docs/、http://example.com/docs/test.doc和http://example.com/docs/?page=1时浏览器会自动发送先前的Authorization Header,而http://example.com/other/和https://example.com/docs/不会发送,需要重新验证。(参见 RFC 7617 2.2. Reusing Credentials)
Basic Auth最大的安全漏洞在于对密码进行明文传输(尽管经过了base64编码,但跟明文无异),所以Basic Auth通常需要配合HTTPS使用。这种验证方式还不防重放(Replay Attack)。现在很少见有服务采用这种验证方式。
Digest Auth
Digest Auth只用摘要值来验证身份,不用明文传输密码,还可以防重放。我们实现一个最简单的应用。
from flask import Flask, request, redirect, render_template
from flask_digest_auth import DigestAuth, make_password_hash

app = Flask(__name__)
app.config['SECRET_KEY'] = 'foo-secret-key'
auth: DigestAuth = DigestAuth("secret-path")

users = {}
users['admin'] = make_password_hash("secret-path", 'admin', '123456')

@auth.register_get_password
def get_password_hash(username):
    return users.get(username)

@auth.register_get_user
def get_user(username):
    if username in users:
        return {"username": username}
    return None

auth.init_app(app)

@app.get("/admin")
@auth.login_required
def admin():
    return render_template("secret.html")

if __name__ == "__main__":
    app.run()
初次访问/admin路由时服务器返回WWW-Authenticate: Digest realm="secret-path", nonce="MjQ5ODkxODU0Nw.aqgMag.Bbxymw21v8cFvF1T9REueRbsi_w", opaque="Mjk0NDc5Njc1Nw.aqgMag.PL6QtVO2qRimpCSEwdMxEuRSdng", qop="auth,auth-int"。
用户输入对应的密码后,浏览器在Authorization Header放Authorization: Digest username="admin", realm="secret-path", nonce="MzU2MjU1MzAw.aqgL2A.ceyzaVy7zEo1z5Xde9BtRoEz1iI", uri="/admin", response="aee55ad787a9c950b831ddfe9df88cdf", opaque="MTQwNzgzODUxOA.aqgL2A.wP4E08IN0BzYKQqrgSoxG26Yihg", qop=auth, nc=0000000f, cnonce="cda1b7777dcd4e90",用户就能访问到受保护的路由了。(这两次请求的nonce不一样,每次请求都会生成一个随机的nonce,后面计算的时候需要用浏览器这一段的信息)
参数比刚才的Basic Auth多多了,我们看一下发生了什么。
WWW-Authenticate头部中各字段的作用:
| 名称 | 作用 |
|---|
| nonce | 服务端生成的随机唯一字符串 |
| opaque | 服务端指定的字符串,客户端需要原封不动返回 |
| stale | 标志,指示由于nonce值过时而拒绝了来自客户端的上一个请求 |
| algorithm | 哈希算法,SHA256、MD5等 |
| qop | 必填,值auth表示身份验证,值auth-int表示具有完整性保护的身份验证 |
| charset | 字符集 |
| userhash | 标志,指示服务端是否支持用户名哈希 |
Authorization头部各字段的作用:
| 名称 | 作用 |
|---|
| response | 按照规则计算出的十六进制数字串(hex) |
| username | 用户名 |
| realm | 略 |
| uri | 请求的uri |
| qop | 指示客户端采用的qop |
| cnonce | 客户端提供的字符串 |
| nc | 必填,nonce count,防重放 |
| userhash | 指示用户名是否被哈希 |
response 的计算规则
response=KD(H(A1),nonce:nc:cnonce:qop:H(A2))
H():哈希函数,如 MD5、SHA-256
KD():密钥派生函数,本质是 H(secret, data)
对于普通算法来说,
A1=username:realm:passwd
对于会话算法(-sess),
A1=H(username:realm:passwd):nonce:cnonce
当 qop = auth 或未指定:
A2=Method:request-uri
当 qop = auth-int:
A2=Method:request-uri:H(entity-body)
用户名哈希
username=H(username:realm)
我们用这种方法计算一下刚才试验的结果。
| 名称 | 值 |
|---|
| realm | secret-path |
| nonce | MzU2MjU1MzAw.aqgL2A.ceyzaVy7zEo1z5Xde9BtRoEz1iI |
| cnonce | cda1b7777dcd4e90 |
| opaque | Mjk0NDc5Njc1Nw.aqgMag.PL6QtVO2qRimpCSEwdMxEuRSdng |
| username | admin |
| password | 123456 |
| uri | /admin |
| qop | auth |
| algorithm | 没有指定,默认MD5 |
| method | GET |
| nc | 0000000f |
A1=admin:secret−path:123456A2=GET:/admin
A1哈希得到05a6b7c3154d30026f5009344ec192ab,A2哈希得到0b039339067eeaeff93a7d25514492d1。
response = H(05a6b7c3154d30026f5009344ec192ab:MzU2MjU1MzAw.aqgL2A.ceyzaVy7zEo1z5Xde9BtRoEz1iI:0000000f:cda1b7777dcd4e90:auth:0b039339067eeaeff93a7d25514492d1),得到aee55ad787a9c950b831ddfe9df88cdf,跟刚才试验的结果相同。
对于服务器来说应该怎么验证response呢?客户端明文给服务端传了用户名,服务端里存储着用户名对应的密码,只要在服务端这里再进行一次哈希,比对一下两次哈希是否相同即可。
在Postman中对请求进行重放,发现服务器不认。注意直接在浏览器重放没用,因为服务器在浏览器验证成功后存了一个session cookie。
Session Cookie
Cookie是以键值对形式存储在浏览器的一些短文本。但cookie可以被轻易查看和修改,如果将一些重要的东西以明文形式存在cookie中,不亚于直接将钥匙给小偷。CTF Web也只有教新手查看cookie的题目会这么出。
但如果服务器将一些信息存在服务器本地(session),然后提供了一个标识字符串给浏览器(cookie),服务器可以通过访客的cookie识别到对应的信息,信息对访客来说一般是不可读的(二般情况我们等会讲),避免了查看和篡改的风险。

下面看用flask构建一个简单的服务。
from flask import Flask, session, redirect, url_for, request

app = Flask(__name__)
app.secret_key = "change-me"

@app.route("/")
def index():
    if "username" in session:
        return f"""
        <h1>欢迎回来,{session["username"]}!</h1>
        """
    return "<h1>请登录</h1>"

@app.route("/login", methods=["GET", "POST"])
def login():
    if request.method == "POST":
        username = request.form.get("username", "")
        if username:
            session["username"] = username
            return redirect(url_for("index"))

    return """
    <form method="post">
        <input type="text" name="username">
        <input type="submit" value="登录">
    </form>
    """
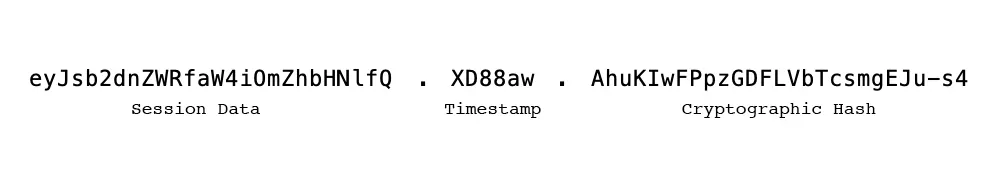
登录之后会发现多了一个名为session的cookie,值为eyJ1c2VybmFtZSI6ImFkbWluIiwidmlzaXRzIjowfQ.aqlKYw.uJksUqvQTxa_pmVIkBDyTe9AqQ8。此前有接触过类似东西的小伙伴可能会觉得这是jwt,实则并非。我们可以在Flask Session Cookie Decoder中读出session包含的内容。比如我们这个session的内容是:
{
    "username": "admin",
    "visits": 0
}
Flask session由三个部分组成,分别是数据、时间戳和签名组成,数据实际上是可读的,但不好篡改,因为有secret key。2服务器用相同的方式生成一个session比对后就能发现是否被篡改。这点跟后面的jwt有些相似,这样服务器就不用再维护一个数据库来存储一堆随机的cookie与它们的session的对应关系了。
但如果这个secret key够弱(比如我们文中的这个),就可以用弱口令词典去爆破。
PS C:\> flask-unsign --unsign --cookie "eyJ1c2VybmFtZSI6ImFkbWluIiwidmlzaXRzIjowfQ.aqlKYw.uJksUqvQTxa_pmVIkBDyTe9AqQ8"
[*] Session decodes to: {'username': 'admin', 'visits': 0}
[*] No wordlist selected, falling back to default wordlist..
[*] Starting brute-forcer with 8 threads..
[+] Found secret key after 42240 attempts
'change-me'
得到secret key之后就可以随意伪造session了。除了用flask-unsign之外,还可以自己搭一个flask去签发假session,也可以用脚本签发。
from flask.sessions import SecureCookieSessionInterface
from itsdangerous import URLSafeTimedSerializer

class S(SecureCookieSessionInterface):
    def get_signing_serializer(self, secret_key):
        return URLSafeTimedSerializer(
            secret_key,
            salt=self.salt,
            serializer=self.serializer,
            signer_kwargs=dict(
                key_derivation=self.key_derivation,
                digest_method=self.digest_method,
            ),
        )

serializer = S().get_signing_serializer('change-me')
fake_cookie = serializer.dumps({'username': 'admin', 'visits': 999})
print(fake_cookie)
Flask也有其他session相关的库,比如flask-session,它提供了一种server-side session,也就是session的内容存储在服务器上。对应的有client-side session,也就是我们刚才见识的flask默认的session。
我们可以用这个代码来看看server-side session。
from flask import Flask, session
from flask_session import Session
app = Flask(__name__)
SESSION_TYPE = 'filesystem'
app.config.from_object(__name__)
Session(app)
@app.route('/set/')
def set():
session['key'] = 'admin'
return 'ok'
@app.route('/get/')
def get():
return session.get('key', 'not set')
if __name__ == "__main__":
app.run()
浏览器先访问/set/,再访问/get,名为session的cookie值为FGN9IPiXxrCrjRLy5uPCMru-Y8zOxnHMfuipu9hSFtU。这个字符串就不太能读了。我们发现在我们的代码目录下多出了一个名为flask_session的文件夹,session的信息就存储在里面。感觉里面存储了序列化的东西,可以用下面这个脚本大致读出来{'_permanent': True, 'key': 'admin'},但在此之前还存了一些字符,究竟是什么意思,具体机制有待探究。
import pickle

with open('./f98473cdd5c467387ed7280ce6be805d', 'rb') as f:
    data = f.read()

obj = pickle.loads(data[15:])
print(obj)
Session Cookie这种验证方式不防重放,如果被窃取到了攻击者就可以原封不动地用session伪装用户进行操作。要防重放的话就要用其他手段(比如多加一个nonce等等)。对于client-side session来说保护内容不被篡改其实就是保证有一个强的secret key,而server-side session则没有篡改的问题。
当然server-side session虽然不存在secret key导致的问题,但面临着会话劫持攻击的风险。尽管目前成熟应用的sessionid都很复杂,难以预测和暴力破解,但需要采取措施防范攻击者窃取sessionid。这一点在本文上下都有提到。
Bearer Token
这个验证本身非常简单,很多服务都在用,就是在Authorization头里面加服务器给的token就可以了。
Authorization: Bearer <token>
对于服务器来说一般需要维护一个token的数据表,跟server-side session差不多。本身不防重放,需要使用HTTPS等手段保护token。
这个鉴权机制本身非常简单,但如何保护token,防护攻击需要一些策略。
首先,最基础的就是HTTPS,没有它一方面数据会像前面提及的那样裸奔,用它来抵御中间人攻击等。
其次,token本身不能直接放在cookie里,因为如果用户被诱骗访问https://example.com/buy之类的接口,浏览器会自动发送cookie内容,完成鉴权,在不经意间完成敏感操作。这就是跨站请求伪造(CSRF)攻击。
那么,token应该存哪呢?token应该作为返回值,由前端存到localStorage中。这样浏览器在访问链接时并不会主动发送token,而是由前端将token放到接口请求的Authorization头部。
但即便这样,恶意的js脚本还是能访问到localStorage,面临xss攻击的问题,可以交由Content-Security-Policy和前后端的过滤机制来防范。
JWT
前面Bearer Token一般是不可读的,前端收到服务器发过来的token不知道这个字符串代表着什么意思,如果要获取用户信息的话还需要向类似auth/me之类的接口获取数据。有没有既能鉴权,又能包含用户信息的呢?
你可能想到前面的client-side session。除了这个,还可以用JWT(JSON Web Token)。
在介绍JWT之前,讲一个场景。拿server-side session举例子,服务器先将用户的id等信息存到session中,并将session-id存到cookie,后续用户发送携带session-id的请求,服务器再到session中查找信息。这个场景对单点服务没有问题,但如果后端是一个服务器集群呢?上游的cdn会将请求发送到其中一个节点,此时很有可能会出现session不在该节点的问题,用户的鉴权态就无效了。
要解决这个问题,session就不能存储在节点自己的内存中了,可以存储到统一的数据库中。但每次验证都要从数据库中取信息,多了来回的耗时,压力也给到数据库这里。而且数据库一旦挂了,所有需要鉴权的服务统统都挂了。
另一种方案是服务器索性不保存session了,所有数据都保存在客户端,每次请求都发回服务器。这就是JWT。
JWT由三个部分构成,头部(Header)、载荷(Payload)和签名(Signature),每个部分用.分隔。
下面用PyJWT库生成json web token。
import jwt

payload = {"username": "admin"}
secret = "secret"
encoded_jwt = jwt.encode(payload, secret, algorithm="HS256")
print(encoded_jwt)
运行得到eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VybmFtZSI6ImFkbWluIn0.qQSekbR5BFKQPc3_7gUiDY6Q9y7RojKzvBTLJ9jGtec,可以在JWT 解析工具查看这个字符串每个部分的含义。
header部分描述jwt的元数据,alg为jwt签名用的算法(默认为HMAC SHA256),typ为JWT:
{
  "alg": "HS256",
  "typ": "JWT"
}
body也是一个json对象,要使用Base64URL算法转成字符串,官方提供了一些字段供选用:
- iss (issuer):签发人
- exp (expiration time):过期时间
- sub (subject):主题
- aud (audience):受众
- nbf (Not Before):生效时间
- iat (Issued At):签发时间
- jti (JWT ID):编号
可以用相同的库进行jwt的解析,当密钥不相同时会抛出jwt.exceptions.InvalidSignatureError异常。
secret = "fakesecret"
decoded_jwt = jwt.decode(encoded_jwt, secret, algorithms="HS256")
print(decoded_jwt)
签发jwt同样需要一个强密钥,不然会被暴力破解。这里尝试用字符集进行暴力破解,用时比较长,用弱密码字典会更快,比如说用rockyou字典77ms就出来了。
./jwt_tool.exe brute -token "eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VybmFtZSI6ImFkbWluIn0.qQSekbR5BFKQPc3_7gUiDY6Q9y7RojKzvBTLJ9jGtec" -minLen 4 -maxLen 10 -charset "qwertyuiopasdfghjklzxcvbnm" -threads 0
尝试次数: 143933669  当前密钥: sescms
成功破解密钥!密钥为: secret
总尝试次数: 144096418, 耗时: 4m7.4560252s
./jwt_tool.exe crack -token "eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VybmFtZSI6ImFkbWluIn0.qQSekbR5BFKQPc3_7gUiDY6Q9y7RojKzvBTLJ9jGtec" -dict ".\rockyou-65.txt"
成功破解密钥!密钥为: secret
Measure-Command { ./jwt_tool.exe crack -token "eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1c2VybmFtZSI6ImFkbWluIn0.qQSekbR5BFKQPc3_7gUiDY6Q9y7RojKzvBTLJ9jGtec" -dict ".\rockyou-65.txt" }

Milliseconds      : 77
Ticks             : 770263
TotalMilliseconds : 77.0263
除此之外,jwt payload并没有加密,所以不能把一些敏感信息放到jwt中。
jwt在应用的过程中有很多漏洞,比如alg=none和加密算法混淆等,对应的也有很多的利用方法。可以阅读Burpsuite靶场-JWT漏洞原理总结及复现这篇文章了解。
对此,我问了一下在研究攻防的CopperKoi同学。他补充了JWT在攻防中主要就是跨站、爆破和伪造。
在session cookie中,我们想要吊销某个session非常容易,在服务器中将session标记为删除(不物理删除,便于审计)即可。但JWT并没有这种机制。如果将JWT存进数据库,维护状态的话,那跟session cookie除了可读性之外就没差别了。这篇文章提供了黑名单和白名单两种方法,黑名单就是将被吊销的JWT存进Redis之类的数据库中,每次校验JWT时查一下数据库。
TOTP
认证因素分为这样几类:
- 知识因素(Knowledge factors):用户所知内容,例:密码、PIN码、共享秘钥、与自身相关的信息
- 持有因素(Possession factors):用户拥有的东西,比如身份证、护照、安全令牌或智能手机
- 属性因素(Inherence factors):用户具备的特征,通常是生物识别技术,物理特征映射的个人属性,如指纹、面部、声音,还包括行为识别,例如说话方式、走路方式、打字方式识别。
TOTP作为双因素验证(2Fa)中比较常见的一种方法,可以通过验证用户的持有因素来提高安全性。
因为用户的持有因素可能丢失、失窃,所以TOTP一般不作为服务唯一的验证因素。
在开启TOTP时,服务器会先生成一个密钥。
import pyotp

secret_key = pyotp.random_base32()
print(secret_key)
随后会向前端返回一个链接,label是用户的名字,secret是上面经过Base32编码后的密钥,issuer代表应用名。
totp = pyotp.TOTP(secret_key)
uri = totp.provisioning_uri(name="admin", issuer_name="totp test")
print(uri)
前端将链接转换为二维码供用户扫描,用户将这个链接的信息添加到设备的TOTP生成器上。用户再次登录时,后端可以计算用户的TOTP,并将两者进行比对。
user_code = input()
if totp.verify(user_code):
   print("Valid")
else:
   print("Invalid")
TOTP本身貌似没有什么值得提的攻击方式。有的就是30秒内TOTP可以重用(CVE-2025-6014、CVE-2026-57574)这种有些局限的漏洞,或者加密算法可预测这些。
OAuth / OpenID Connect(OIDC)
认证(authentication)和授权(authorization)是两个不同的过程,认证负责认出“你是谁”,而授权负责找出“你能做什么”。前面我们提到的JWT、session cookie等常把认证和授权合并在一起(比如将权限信息写在JWT里等等),我们不需要严格区分。但到这里,我们需要区分这两个过程。
WebAuthn
to be written
Reference
Basic Auth:
Digest Auth:
Bearer Token:
Session Cookie:
JWT:
TOTP:
OAuth: